(本文作者为 海豚研究,钛媒体经授权发布)
文 | 海豚研究
博通近段时间以来股价持续下跌,主要是受到了 “Meta 出售算力” 和 “下游大客户寻求其他供应方案” 的影响。其中前者是市场β层面的影响,后者是对公司 alpha 层面的担忧。
其实一开始市场对博通 AVGO 的关注度,主要是希望它能对抗英伟达阵营。而今博通也开始面临像类似于的问题,下游大客户也开始寻求其他选择:①大客户谷歌供应链的多元化;②Anthropic 的订单从整机交付转变为 XPU 核心芯片交付。
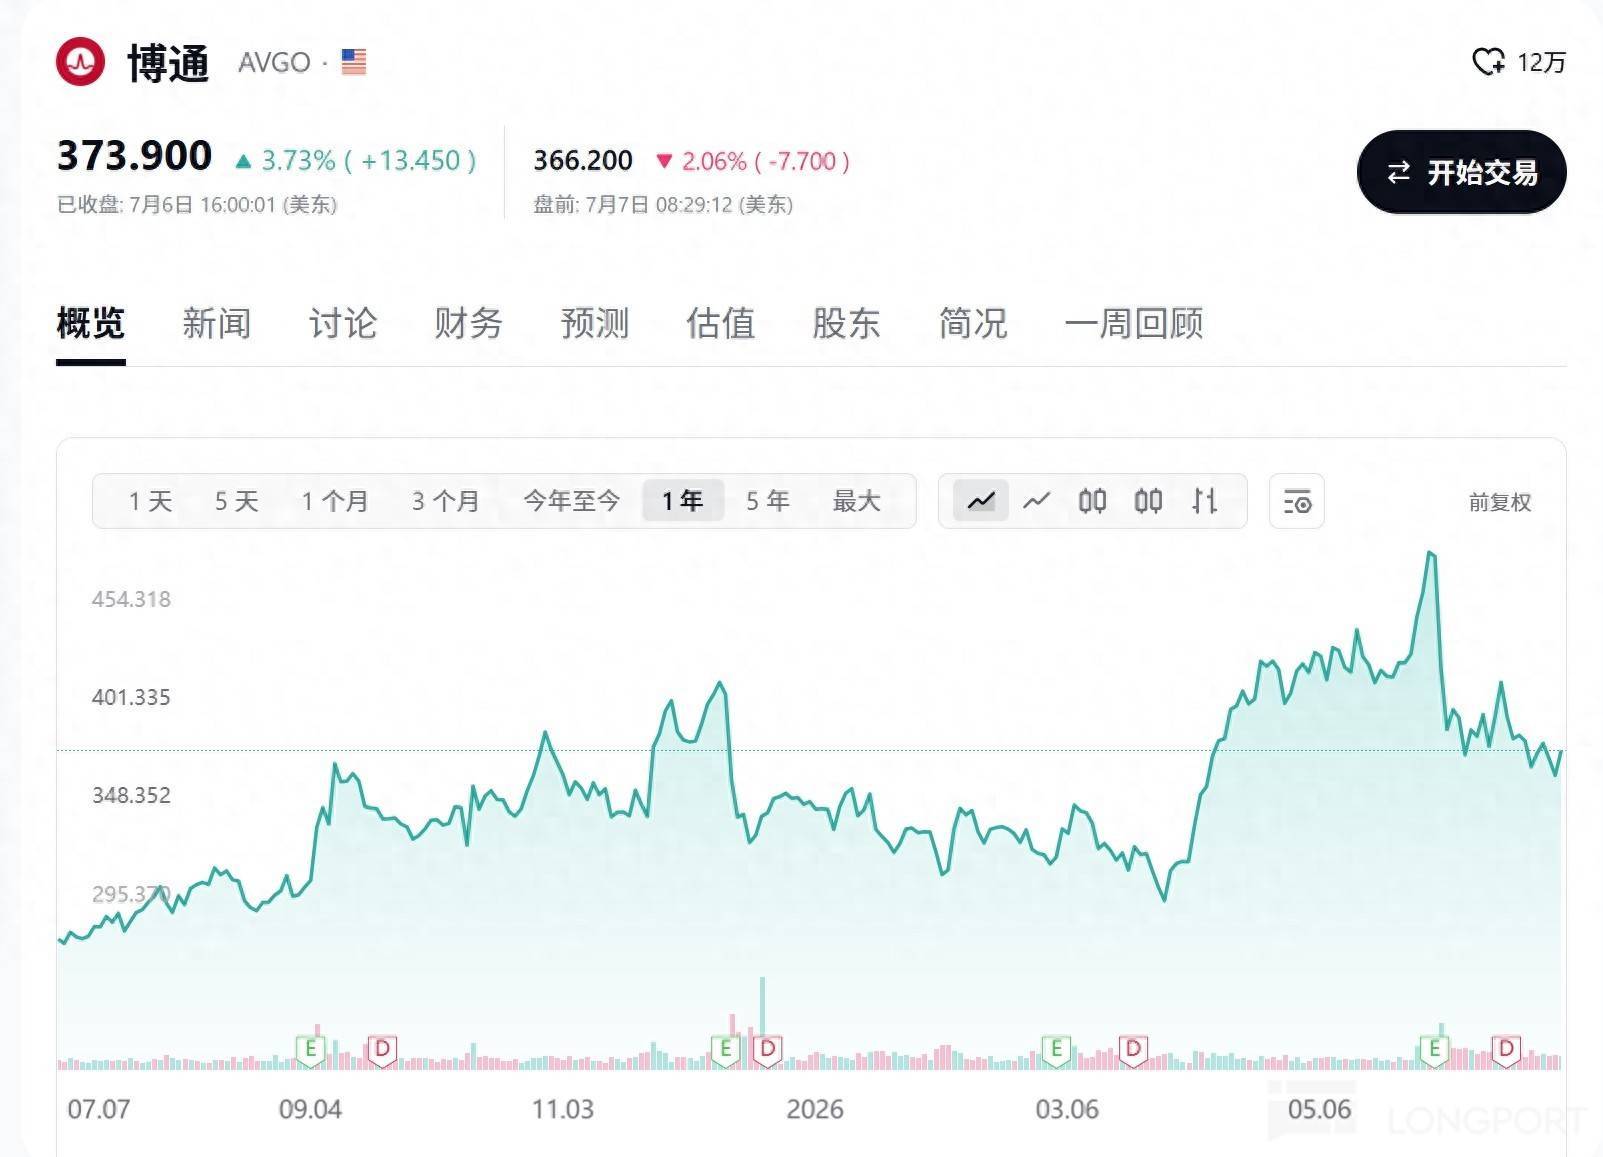
“谷歌 + 博通 AVGO” 的长期合作,成功在英伟达几乎垄断的 AI 芯片市场 “撕开了个口子”,当前博通在 AI 芯片的市场份额已经达到 1-2 成。而自今年年初以来,谷歌陆续宣布了在供应链多样化的进展,博通管理层也在财报后确认了谷歌在其他供应商的事实。
即便谷歌和博通的合作已经达到 10 年以上,并在 AI 芯片市场取得了不错的效果,但似乎两家的合作并没有那么牢靠?
①TPU 的第二供应商
对于下一代 TPU,谷歌预计将发布 TPU8i(推理)和 TPU8t(训练)两款,分别是面向推理阶段和训练阶段。不同的是,谷歌将在下一代中引入新的供应商联发科 MTK 来供应 TPU8i,博通 AVGO 则继续供应 TPU8t 产品,这是谷歌首次在 TPU 供应商中引入第二家厂商。
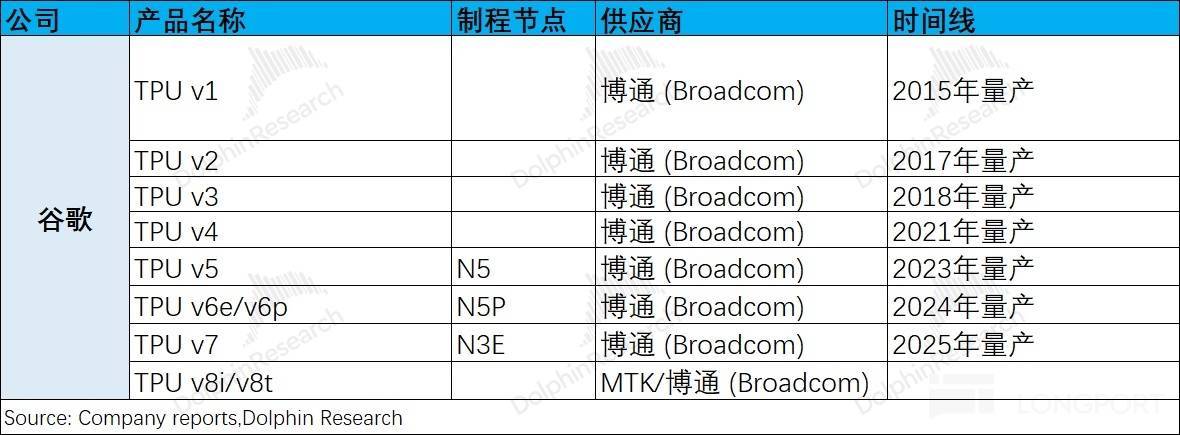
②与 Marvell 深化合作
Marvell 原本与谷歌的合作主要是在 Axion3 CPU 领域,并未涉及数据中心算力领域。市场后续又传出谷歌正在和 Marvell 洽谈共同开发两款新 AI 芯片,包括一颗内存处理单元(MPU)和一颗面向推理专用的 TPU。在 6 月 Computex 大会期间,又爆出了 Marvell 将为谷歌提供定制网络通信芯片的消息。
以上,对于下一代 TPU8i(推理)产品,谷歌正在构建一个 “去博通化” 的多供应商架构。
1)谷歌为什么想单飞?
从谷歌的角度的出发,引入联发科能实现成本降低的同时(JPM 调研指出,联发科的解决方案便宜 40%~50%),还能获得更强的设计主导权。比如在之前传统的博通 “交钥匙” 的方案中,博通负责原材料和代工环节都进行了转手加价,其中主要包括先进封装(CoWoS)代工和 HBM 采购(业内披露加价幅度在 15-20%)。
而对于谷歌而言,希望能调整与 ASIC 厂商(博通)的原有合作方式,引入 COT 模式(Customer-Owned Tooling 客户自有工具/自主设计流程),即谷歌能自行设计芯片模板、直接采购晶圆产能及存储等,而不是让单一的 ASIC 供应商负责全部流程。
2)合作模式发生了什么变化?
通常意义上,可以将 ASIC 分为前道和后道两部分,其中前道主要是 ASIC 芯片设计环节(芯片架构定义、RTL 编码、IP 集成等),而后道包括了晶圆制造、CoWoS 封装、HBM 采购及测试及良率管理。
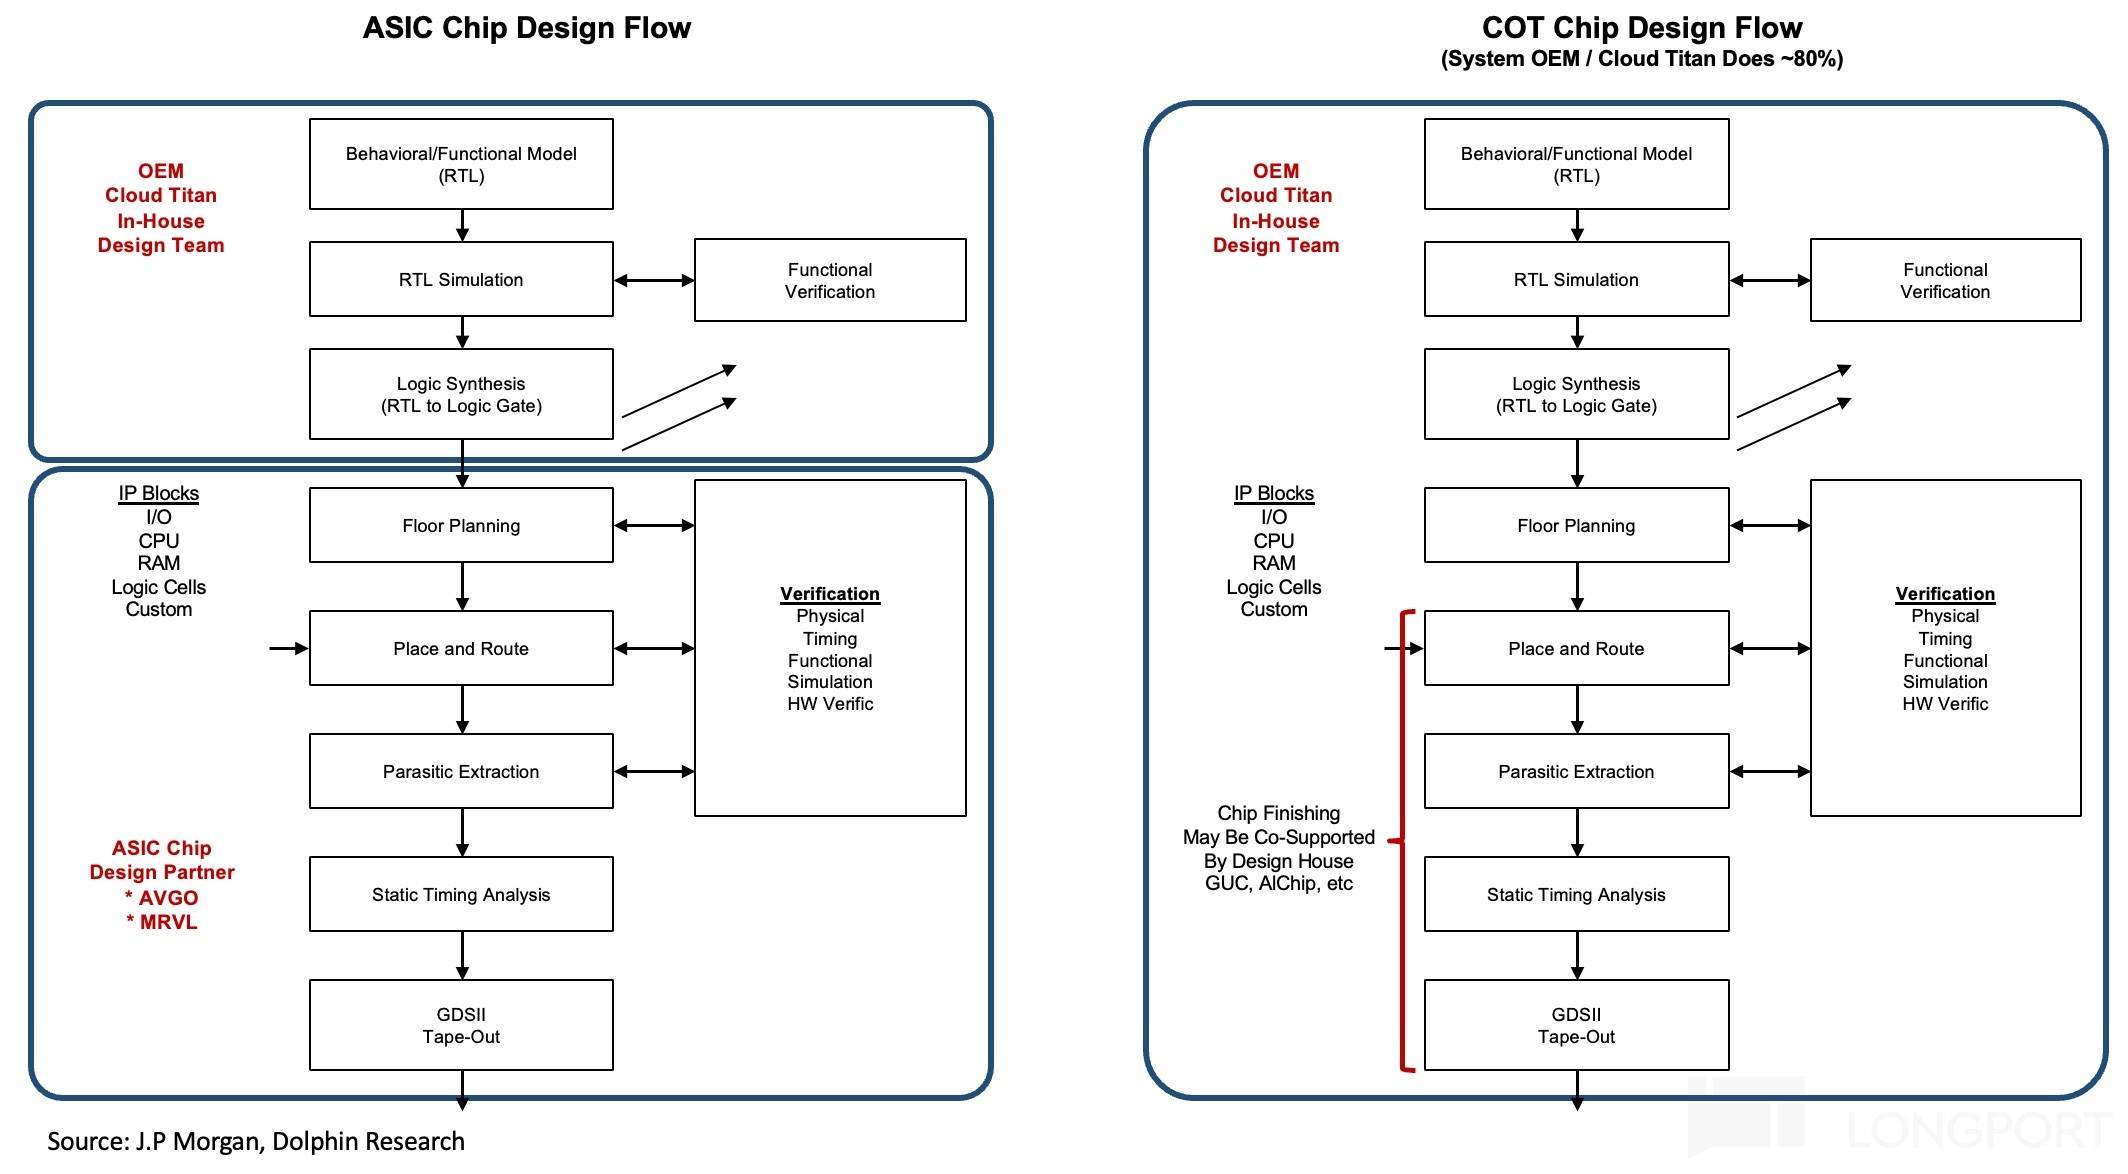
在原有的博通合作模式中,博通参与了前道环节中核心 IP 供应及全部的后道环节。而在新的 COT 模式(如 MTK)下,前道环节基本都是由谷歌来负责,而将后道中的部分环节交给联发科去执行,比如标准化的后端工程设计、传统封装管理等。
a)至于博通在前道环节中卡位的顶级 SerDes IP(400G/ lane),由于博通明确不会授权给非博通流片的芯片。因而在 COT 方案中,将选择联发科自研(224G SerDes)或第三方、性能较低的 SerDes(约占芯片总成本的 25-30%)。
b)后道环节中,此前全部是由博通一手包办,但在 COT 模式下,谷歌将后端设计和标准制造管理外包给了联发科,将拥有完整的架构/IP/系统设计。至于流片管理(找台积电要产能)、HBM 采购,是由谷歌自己去争取,避免了 “中间商赚差价” 的情况。
c)MTK 在后道环节中分担的活:
- 标准化的后端工程设计:联发科的 TPU8i 是单芯片方案(单块计算 die+ 一颗 I/O die+ 六层 HBM3e),物理实现相比于博通的双芯片方案(两块计算 die+ 一颗 I/O chiplet+ 八层 12-high HBM3e)简单得多,不需要处理复杂的多 Die 互连和超高性能 SerDes 带来的信号挑战;
- 传统封装管理:采用相对成熟的 CoWoS-S 标准封装/英特尔 EMIB-T,而不是博通高难度定制化的 CoWoS-L/3D SoIC。
简而言之,新的合作模式下,前道环节主要是谷歌自己来负责,Marvell 能提供网络与连接芯片,部分后道环节将由联发科 MTK 辅助完成。
3)谷歌离得开博通吗?
我们认为谷歌很难完全脱离博通,后续训练芯片的增量仍将由博通提供,而推理芯片 TPU 8i 能否量产交付将是谷歌转向 COT(后续仍有 v9/v10/…多代)的先决条件。
联发科做的是相对容易的 “单芯片方案”,但依然还是经历了多次的项目推迟;而博通从 2025 年的 TPUv7 就开始为谷歌 “双 die” 产品的量产,两家的交付能力差距依然是相当明显的。
亚马逊的 Trainium1、2 是基于 COT 方案实现的,可以为谷歌提供经验。亚马逊自 2015 年以约 3.5 亿美元收购 Annapurna Labs 起步,历经十年,已将芯片的前端设计、后端物理实现等大部分核心环节内化,且不谈谷歌走向内化需要多长时间,我们认为谷歌与亚马逊的核心差异点在于Scale-up 互连架构的选择。
Trainium 的 Scale-up 网络基于 PCIe,而 PCIe 是标准化物理层、存在多家商用 IP 供应商(
Synopsys/Cadence/Alphawave 等)。反观谷歌,其 ICI/OCS 是自研的高带宽专有 fabric,高速 SerDes 并无标准化的商用替代品,而博通明确不向非博通流片的芯片授权其顶级 SerDes IP。意味着谷歌的 Scale-Up 方案只要不转向,对于 SerDes 的需求便是确定的,而目前 MTK(224G)与博通(400G/lane)的 SerDes 方案之间仍存在代差。那么 224G 大约是什么水平呢?其实如果 MTK 能实现,大约也能拉近与博通、英伟达之间的差距。至于下一代方案中,英伟达和博通都将推出 400G 以上的产品。
虽然市场上有更成熟、先进的 SerDes 产品,但谷歌还是想寻求 “降本” 和 “性能” 两方面的平衡,公司也计划将 MTK 的 224G 主要去承担 AI 推理的相关任务。如果能顺利转为 COT 方案后,能让公司实现降本的同时,还能对博通有了更多的 “议价” 底气。
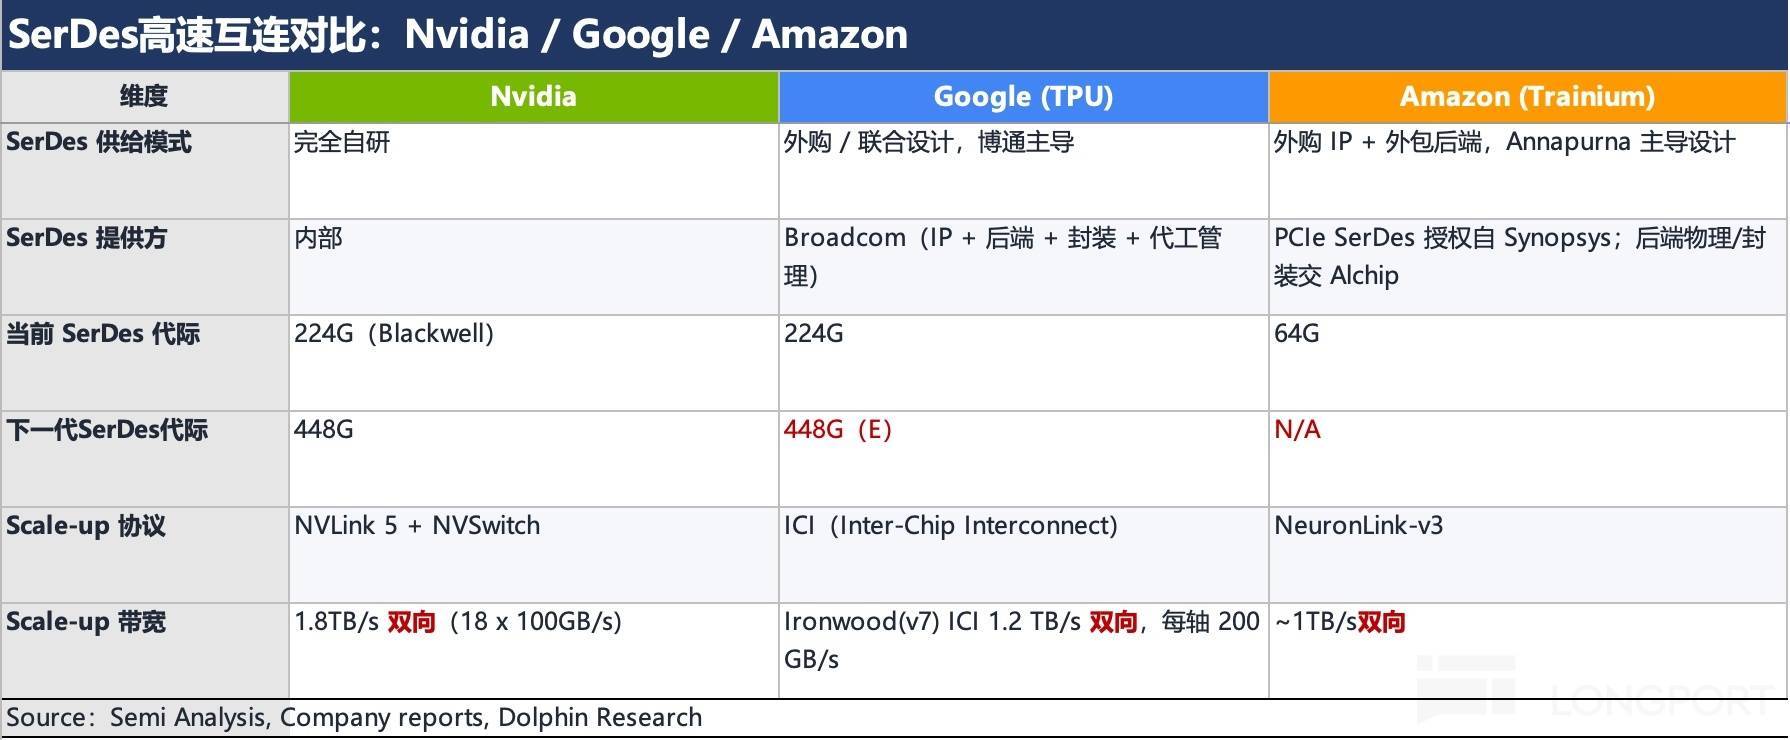
但即便技术力赶不上博通,奈何联发科太便宜,有调研指出谷歌下下代产品 v9 存在降规的可能性,从博通的 400G SerDes 转向联发科的 300G SerDes,若 v9 将由联发科主导,意味着谷歌 v8i 的 COT 方案跑成。但另有调研指出,谷歌 COT 团队目前仍在艰难优化 v8 项目。
鉴于两种市场信息互相打架,不妨关注博通与谷歌签订的长期协议,协议内容由博通为谷歌未来若干代 TPU 开发并供应定制 TPU,我们认为长期协议对谷歌供应商锁定增加了确定性(尽管不具备排他性)。因为根据 Trainium-3 的产品周期,从概念到量产出货的完整周期约为 3 年,合作伙伴敲定发生在发布前约 18 个月,在研发周期后段很难再调整方向。
综合先进制程节点接入、SerDes IP、前道工程深度、先进的芯片/封装设计、计算/网络/存储架构 know-how 等一揽子能力,博通现阶段仍具有领先优势,加之二者长达 10 年的合作关系,短中期来看谷歌与博通完全脱钩的可能性较低。
二、Anthropic 的订单转变博通 AVGO 与 Anthropic 的订单从 “整机柜” 方式转成只提供 “XPU 等芯片”,这直接影响博通收入预期的同时,也会让市场担心博通网络连接等方面的能力。
首先要理解“整机柜交付”,其中博通不会自己生产线缆、进行组装等,更多是一种 “总包” 的模式。具体是将物理 制造、组装、线缆集成等工作,交给 ODM、OEM 及第三方供应商来完成,博通将提供芯片、设计和系统架构,但会把整机柜收入都计入自身营收中。
在整个机柜中,会包括 ASIC/GPU 芯片、存储、网络连接组件、电源系统、散热/冷却组件、机壳等机械件、系统组装等方面。博通自身将主要提供其中的 XPU 芯片、以太网交换芯片 (Tomahawk)、NIC、PCIe switch、SerDes/光 DSP,以及 scale-up/scale-out 的网络方案和整柜参考设计。
结合英伟达机柜 BOM 价值量占比以及市场对 Anthropic 订单调整后产生的收入影响(100%->25%)来看,预估博通的机柜方案中 TPU/XPU 的价值量占比 (25%) 将是明显低于英伟达的。
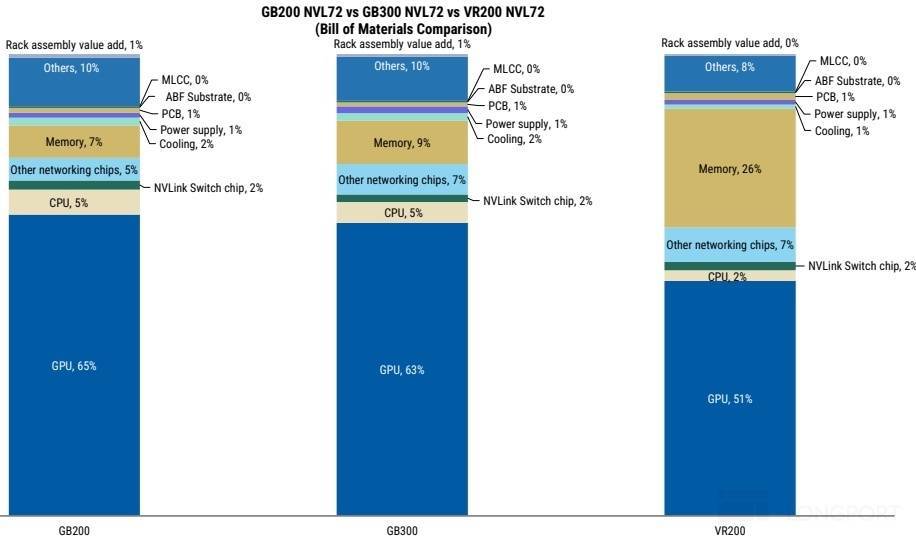
Source:MS,Dolphin Research
从 Anthropic 角度出发,最主要是因为:①早期的规模较小,整机柜的交付比较方便,而规模提升后经济性就不足了;②不想受制于谷歌、博通等公司,想掌握产业链的主导权。
将谷歌和博通在 TPU 的合作进行拆解,能清楚的看到谷歌 TPU 架构里
scale-up/scale-out/scale-across 三层网络的架构、拓扑、协议基本都是谷歌主导的,博通核心是提供物理层的芯片,比如 ASIC、SerDes 等产品: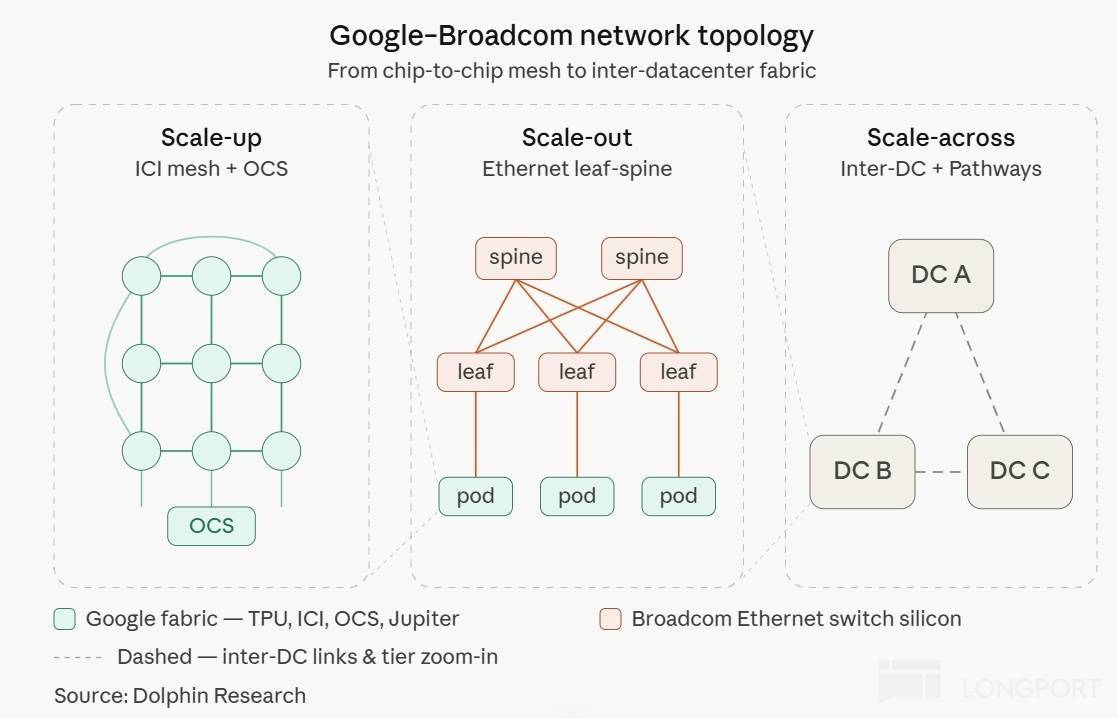
1)Scale-up(计算集群 Pod 内部):核心都是谷歌自己的东西
①ICI:谷歌自研的芯片间互连协议。每个 Ironwood 主机有 4 颗 TPU,一个机架 64 颗组成一个"cube
康乾配资提示:文章来自网络,不代表本站观点。